IA imagen a video gratis: la técnica que transforma videos en tiempo real con cambios semánticos y control total
Tiempo de lectura estimado
10 minutos
Puntos clave
-
–
- Gratis y rápido: más veloz que en tiempo real en GPU H100, usable en GPUs comunes.
- Cambios semánticos potentes con ControlNet, manteniendo estructura y movimiento.
- Coherencia espaciotemporal gracias a compresión 1:192 y atención global.
- Iteración ágil: boceta en baja, bloquea idea y escala calidad después.
- Casos prácticos: social media, VFX, educación, marketing, apps con API.
- Buenas prácticas: prompts claros, clips cortos, seeds fijos, de-flicker en post.
–
–
–
–
–
Tabla de contenidos
-
–
- Introducción
- Qué es y por qué importa
- Lo que puede hacer (demostraciones clave)
- Cambios semánticos y estilización creativa
- Rendimiento y eficiencia
- Cómo funciona
- Casos de uso prácticos
- Limitaciones y buenas prácticas
- Cómo empezar (guía rápida)
- Conclusión
- Preguntas frecuentes (FAQ)
–
–
–
–
–
–
–
–
–
–
Introducción
¿Y si pudieras convertir una foto en un clip vivo en segundos? ¿Y si pudieras reimaginar un video entero, cambiar la luz, el estilo o incluso los objetos, sin pagar suscripciones caras?
La IA imagen a video gratis ya lo hace posible. Funciona más rápido que en tiempo real en GPU modernas, entiende tus prompts y te da control fino con modelos de control. Aquí verás qué hace, cómo lo logra, ejemplos claros, y los primeros pasos para usarlo.
Sigue leyendo: lo verás con demos y con una explicación simple que cualquiera puede entender.
Qué es y por qué importa
IA imagen a video gratis es un modelo de imagen a video que:
-
–
- Continúa una imagen estática como si fuera el primer fotograma de una historia.
- Reimagina un video completo, respetando su movimiento base, pero cambiando estilo, objetos o iluminación.
–
¿Por qué importa?
-
–
- Es gratis para todos. Puedes experimentar sin miedo al costo.
- Da rendimiento de gama alta sin hardware prohibitivo.
- Ofrece posible acceso por API de video generativo, ideal para apps, equipos y flujos de trabajo.
–
–
Breve comparación:
-
–
- Alternativas comerciales logran buena calidad, pero suelen limitar minutos o resolución según tu plan.
- Aquí, con un modelo de imagen a video gratis, puedes iterar más, probar más estilos y llegar antes a una versión buena.
–
Una nota sobre “definir” qué es esto: una definición explica el significado de un término de forma clara y precisa. En técnica, puedes usar definiciones intensionales u ostensivas para entender un concepto. Aquí usaremos ambas: diremos qué hace y lo verás con ejemplos. También puedes contrastar la definición en otras fuentes reconocidas.
Lo que puede hacer (demostraciones clave)
Estos son los superpoderes más útiles hoy:
-
–
- Movimiento plausible de sujetos
-
–
- Un pato que parpadea y sacude el agua con naturalidad.
- Humanos que saludan, sonríen y giran la cabeza sin “saltos” raros.
–
- Cambios de iluminación, con coherencia
-
–
- De luz plana a atardecer dorado, manteniendo sombras y reflejos consistentes.
- De interior cálido a neón nocturno, sin perder el gesto del sujeto.
–
- Movimiento de cámara y “reconstrucción”
-
–
- La IA simula un paneo o zoom que descubre lo que habría fuera del encuadre inicial.
- La escena “respira”: aparece fondo coherente, parallax y profundidad.
–
- Interacción con el entorno
-
–
- Pasos que salpican, pelo que responde al viento, telas que se mueven.
- Correr, saltar o girar con microdetalles creíbles.
–
- Estilización por prompt
-
–
- “Estilo acuarela suave” o “surrealista retrofuturista” aplicado de forma uniforme.
- Conserva las formas clave y el ritmo del movimiento original.
–
–
–
–
–
Todo esto funciona tanto de imagen a video como de video a video. El segundo caso aprovecha el movimiento base del clip para guiar el resultado.
Sigue bajando: entramos al territorio divertido, los cambios semánticos.
Cambios semánticos y estilización creativa
Aquí es donde la transformación de video con IA se vuelve magia práctica.
-
–
- Video a video con modelo de control (ControlNet)
-
–
- Ejemplo: convertir arena en agua pero mantener las olas y la cadencia exactas del material original.
- El “modelo de control” preserva pose, bordes o profundidad, y el modelo principal cambia el “qué” y el “cómo”.
–
- Reemplazo de objetos o estilos
-
–
- De esgrima a Maestro Roshi con palos de golf, o sables de luz. Se preserva la coreografía.
- Gafas normales a gafas de aviador con reflejos, sin perder la mirada.
–
- Estilización artística
-
–
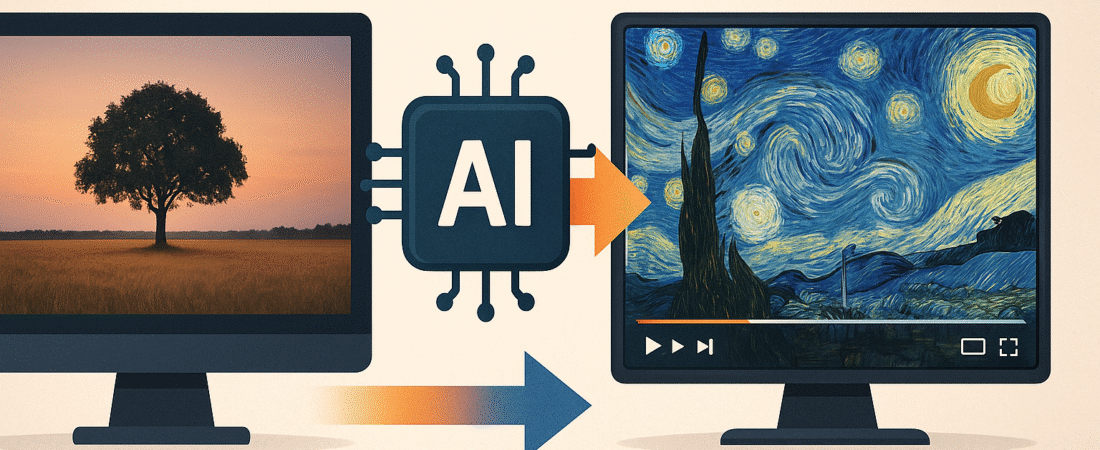
- Estilo Noche estrellada para coreografías: pinceladas dinámicas que siguen brazos y piernas.
- Estilo anime, cómic, óleo espeso o carboncillo, manteniendo volúmenes.
–
- Cambios de escena
-
–
- Lodazal a paisaje invernal con nevada añadida. Copos que caen con dirección del viento.
- Oficina a cafetería vintage, con neón suave y vapor de café.
–
- Cambios de identidad
-
–
- Transformarte en personaje de videojuegos. Aún imperfecto en detalles finos, pero mejora rápido.
- Retoques de pelo, barba o accesorios sin romper la coherencia facial.
–
- Ajuste global de iluminación por prompt
-
–
- “Planeta rojo con atmósfera densa” o “noche nevada con faroles cálidos”.
- La escena entera se reilumina: sombras, brillos y color del ambiente.
–
–
–
–
–
–
Tip: cuando pidas cambios grandes, añade guías de consistencia en el prompt, como “mantener contornos y ritmo original”, y si puedes, añade un mapa de control con ControlNet.
Rendimiento y eficiencia
-
–
- Velocidad
-
–
- En una GPU H100, generar 5 segundos en 2 segundos es posible: más rápido que en tiempo real.
- En GPUs más modestas, aún puedes iterar de forma ágil con resoluciones prácticas.
–
- Tamaño del modelo
-
–
- Menos de 2B de parámetros antes de destilación, suficiente para gran calidad.
- Esto lo acerca a hardware cotidiano e incluso a móvil de gama alta con optimizaciones.
–
- Coste predecible
-
–
- Menos tokens que procesar significa menos coste de atención por cuadro.
- Mejor uso de memoria: clips más largos o más capas de detalle.
–
- Flujo de trabajo real
-
–
- Boceta rápido a baja resolución, bloquea la idea y luego sube calidad.
- Repite cambios semánticos con el mismo control para mantener continuidad.
–
–
–
–
¿Te preguntas cómo logra esta velocidad? Vamos paso a paso, sin jerga pesada.
Cómo funciona (explicado simple, sin jerga innecesaria)
Piensa en un supermercado. En vez de meter a todo el mundo en una única fila lenta, abres cajas rápidas. Eso hace este modelo con tus videos: comprime, atiende lo importante y libera recursos para el movimiento y la coherencia.
-
–
- Autoencoder variacional espaciotemporal (compresión 1:192, 128 canales latentes)
-
–
- Traduce el video crudo a un espacio comprimido donde la esencia ocupa menos.
- 1:192 significa que, por cada 192 “píxeles” originales, guardas 1 unidad compacta con lo esencial del espacio y el tiempo.
- Beneficio: procesas menos datos, pero mantienes textura y movimiento clave.
- Analogía: como guardar una canción en formato comprimido sin perder lo que tu oído necesita.
–
–
–
- Relación píxeles a tokens 1:8000
-
–
- En lugar de convertir cada pequeña parte del video en miles de tokens, aquí hay ~4 veces menos de lo típico.
- Menos tokens = menos coste de atención y más velocidad.
- Analogía: menos palabras para decir lo mismo, pero con la misma claridad.
–
–
- Atención espaciotemporal completa gracias a la compresión
-
–
- La “atención” mira a la vez el dónde (espacio) y el cuándo (tiempo).
- Al estar comprimido, el modelo puede prestar atención global sin colapsar la memoria.
- Resultado: coherencia de un fotograma a otro, menos parpadeo, mejor seguimiento de objetos.
–
–
- ControlNet (modelo de control) como volante opcional
-
–
- Alimentas mapas de bordes, profundidad o pose. El modelo los respeta.
- Así consigues cambios semánticos fuertes sin perder estructura.
–
- Destilación y trucos de inferencia
-
–
- Menos pasos de muestreo, kernels fusionados, y caching de claves/valores.
- Traducido: menos vueltas para llegar al mismo destino, más rápido y con menos coste.
–
- Por qué esta definición importa
-
–
- Dar una definición clara del sistema ayuda a razonar y construir sobre él, similar a cómo en matemáticas una definición precisa fundamenta teoría nueva, siguiendo enfoques comunes en lexicografía y uso general de la palabra definición.
–
–
–
–
–
Resumen mental rápido:
-
–
- Comprime agresivo sin perder lo vital.
- Atiende espacio y tiempo a la vez.
- Controla estructura con modelos de control.
- Optimiza pasos para ir más rápido que en tiempo real, sobre todo en GPU H100.
–
–
–
¿Listo para llevar esto a la vida real? En la segunda parte veremos casos de uso, límites y buenas prácticas, y una guía para empezar hoy con imagen a video y video a video.
Casos de uso prácticos
Creadores y social media
-
–
- Remix de clips en segundos. Cambia luz, estilo o fondo sin rodar de nuevo.
- Series virales: un mismo baile en “estilo Noche estrellada”, anime y óleo espeso.
- A/B testing visual: genera 5 variaciones y elige la que mejor retiene.
–
–
Sugerencias rápidas:
-
–
- Mantén tomas de 3 a 7 s para mayor coherencia temporal.
- Usa video a video con ControlNet (modelo de control) para conservar poses y bordes.
–
VFX y previsualización
-
–
- Previs en tiempo real. Bloquea cámara y ritmo con imagen a video, luego refina.
- Cambios semánticos sin set nuevo: convierte día en noche neón o desierto en costa.
- Itera con director y cliente en vivo, gracias a la velocidad casi de tiempo real.
–
–
Educación y divulgación
-
–
- Visualiza fenómenos: flujo de aire sobre un ala, lava enfriándose, o fases de la Luna.
- Explica procesos con coherencia espaciotemporal: ideal para ciencias y tecnología.
- Usa estilización por prompt para resaltar capas o fuerzas invisibles.
–
–
Marketing y prototipado creativo
-
–
- Storyboards animados. De una imagen del producto a un giro 3D simulado.
- Campañas “mismo gesto, mil estilos”. Coherencia de movimiento, variedad visual.
- Baja costos de prueba: valida conceptos antes de producir.
–
–
Apps y productos
-
–
- Conecta una API de video generativo y ofrece filtros “inteligentes” en tu app.
- Automatiza plantillas: entrada de cliente, salida de video con estilo y branding.
- Escalado por lotes en la nube: ideal para catálogos y UGC moderado.
–
–
Limitaciones y buenas prácticas
Artefactos actuales
-
–
- Manos y dedos en ciertos ángulos pueden fallar.
- Texturas finas (telas, textos pequeños) a veces “bailan”.
- Cambios extremos de identidad pueden romper detalles faciales.
–
–
Cómo mitigarlo:
-
–
- Usa ControlNet de pose o bordes para manos y caras.
- Mantén planos medios; evita primeros planos ultra cerrados al inicio.
- Combina dos pasadas: primero estructura, luego estilización suave.
–
–
Coherencia temporal
-
–
- Parpadeo o “flicker” puede aparecer en fondos muy detallados.
- Movimiento de cámara agresivo exige más control.
–
Trucos prácticos:
-
–
- Sube un poco el peso de coherencia temporal si tu interfaz lo permite.
- Prefiere 12–24 fps para pruebas; aumenta a 30 fps al final si todo está estable.
- Corta en edición: clips cortos enlazados dan mejor sensación global.
–
–
Ética y permisos
-
–
- Respeta derechos de imagen, marcas y propiedad intelectual.
- Señala cuando un clip está generado o modificado por IA.
- Evita deepfakes engañosos o uso sin consentimiento. La seguridad legal importa.
–
–
Prompts y control
-
–
- Estructura tu prompt: escena + estilo + luz + consistencia + detalles.
- Ejemplo: “Cafetería vintage, estilo cine 70s, luz cálida, mantener contornos y ritmo original, grano fino.”
- Añade mapas de profundidad o bordes si quieres control fuerte.
- Limita el “ruido” semántico: menos adjetivos, más claridad.
–
–
–
Rendimiento y ajustes
-
–
- Baja resolución para bocetar; sube al final. El autoencoder variacional y la compresión 1:192 ayudan, pero no hacen milagros si saturas.
- Si tu GPU es modesta, reduce segundos por clip o usa cola por lotes.
- Anota semillas (“seed”). Te permite recrear resultados y hacer pequeñas variaciones.
–
–
Cómo empezar (guía rápida)
Dónde acceder
-
–
- Plataforma gratuita en la web con colas públicas.
- Clientes de escritorio comunitarios con soporte para imagen a video y video a video.
- API de video generativo para integrarlo en pipelines y apps.
–
–
Consejo: empieza online. Cuando el flujo te funcione, pasa a API o local.
Requisitos de hardware
-
–
- Ideal: GPU moderna (RTX 3060 o mejor). Más VRAM = clips más largos.
- Nube: instancias con A10, A100 o GPU H100 si quieres tiempo real o lotes grandes.
- Móvil gama alta: viable con presets ligeros. Espera menor resolución y más tiempo.
–
–
Flujos básicos
Imagen a video (continuación de imagen)
- Sube una imagen base.
- Escribe un prompt claro: estilo, luz, acción breve.
- Elige duración (3–5 s para empezar) y fps 12–24.
- Genera en baja resolución. Evalúa movimiento y ritmo.
- Escala a mayor resolución si todo cuadra.
Video a video con ControlNet (cambio semántico)
- Sube tu clip base.
- Activa ControlNet con mapa de bordes, profundidad o pose.
- Prompt de sustitución: “arena a agua” o “oficina a cafetería vintage”.
- Peso de control 0.6–0.8 para mantener estructura. Ajusta según arte.
- Rinde dos pasadas: base coherente y luego estilización por prompt.
Prompts de arranque
-
–
- “Convertir arena en agua con reflejos realistas, mantener movimiento original, luz cálida al atardecer, textura suave, sin artefactos.”
- “Aplicar estilo Noche estrellada a bailarines, conservar ritmo y contornos, pincelada dinámica, color intenso, sin banding.”
- “Cambiar iluminación a ‘noche nevada’, añadir partículas de nieve coherentes con el viento, luz de faroles cálida, sombras suaves.”
–
–
Pipeline sugerido
-
–
- Explora referencias visuales.
- Boceta a 512–720p, 12–24 fps, 3–5 s.
- Ajusta prompt y peso de ControlNet.
- Bloquea seed y parámetros cuando te guste.
- Sube a 1080p o 4K con upscale si hace falta.
- Pasa un de-flicker ligero en post si hay parpadeo.
- Añade sonido y textos en edición.
- Exporta en ProRes o H.264 según uso.
–
–
–
–
–
–
–
API de video generativo
Endpoints típicos:
-
–
- POST /image-to-video
- POST /video-to-video
- POST /controlnet
–
–
Parámetros clave: prompt, negative_prompt, seed, steps, strength, fps, duration, resolution.
Consejos:
-
–
- Controla colas con webhooks.
- Guarda metadatos para reproducibilidad.
- Lanza lotes nocturnos si no necesitas tiempo real.
–
–
Conclusión
Crear video ya no es un lujo. Con esta IA imagen a video gratis logras cambios semánticos fuertes, estilización por prompt y control fino, incluso en hardware normal. La atención espaciotemporal mantiene la coherencia. El autoencoder variacional y la compresión 1:192 reducen coste. Y si necesitas velocidad, una GPU H100 te lleva por encima del tiempo real.
Empieza hoy:
-
–
- Elige una imagen o clip corto.
- Define un objetivo simple: estilo, luz o sustitución.
- Genera en baja, ajusta, y luego sube calidad.
- Comparte resultados, anota tus mejores prompts y repite.
–
–
–
La transformación de video con IA ya está en tus manos. Construye tu look, prueba ideas en minutos y publica. Si tu meta es velocidad, control y costo cero de entrada, este modelo de imagen a video gratis es tu nuevo compañero de trabajo.
¿Listo para crear? Sube tu primera imagen, escribe tu prompt, y deja que la IA haga el resto. Y cuando publiques, menciona “IA imagen a video gratis” para que otros encuentren la técnica y se sumen a la comunidad.
Preguntas frecuentes (FAQ)
¿Necesito una H100 para buen rendimiento?
No. Una RTX 3060 ya rinde bien para 720p y clips cortos. La GPU H100 acelera a tiempo real y lotes grandes.
¿Se puede usar en móvil de gama alta?
Sí, con presets ligeros y paciencia. Sube a la nube para 1080p o tareas pesadas.
¿Es diferente a “texto a video”?
Sí. Aquí partes de imagen o video (imagen a video y video a video). El movimiento base y la estructura guían el resultado.
¿En qué se diferencia de Sora, Runway o Pika?
Enfoque abierto y coste cero de entrada. Calidad alta y control con ControlNet. Algunos rivales tienen más modelos de cámara o escenas largas, pero con límites de plan.
¿Puedo usarlo comercialmente?
Revisa la licencia del repositorio o la plataforma que uses. Algunas permiten uso comercial, otras piden atribución o restringen ciertos dominios.
¿Audio y voz están incluidos?
Normalmente no. Genera el video y añade audio en post. Algunas integraciones permiten TTS aparte.
¿Qué formato exporta?
MP4 o WebM son comunes. Para post serio, exporta PNG sequence o ProRes si tu herramienta lo soporta.
¿Cuánto dura un clip?
Depende de VRAM y parámetros. Empieza con 3–7 s. Para más, une clips en edición y usa transiciones coherentes.
¿Cómo evito flicker?
Mantén prompts estables, usa ControlNet de bordes o profundidad, baja la fuerza de estilización y aplica un de-flicker suave al final.
¿Puedo controlar cámara?
Sí, por prompt y, en algunos frontends, con “motion strength”. Paneos y zooms suaves salen bien; movimientos extremos requieren más control.
¿Qué hay de la atención espaciotemporal?
Es una pieza clave para coherencia. Gracias a la compresión 1:192 y la relación píxeles a tokens 1:8000, el modelo “mira” espacio y tiempo a la vez sin colapsar memoria.
¿Dónde aprender más?
Revisa documentación de tu plataforma, foros de creadores y canales como Two Minute Papers para contexto y tendencias.
