GPT-5: análisis completo, precios, límites y comparativa con O3 y O4
Tiempo de lectura estimado: 12–14 minutos
Resumen rápido: Key Takeaways
- Modelo unificado con enrutador: un solo GPT-5 con respuesta instantánea y modo razonador (GPT-5 Thinking); OpenAI reestructura su catálogo para simplificar la elección.
- Mejora incremental: más utilidad y eficiencia que “salto cuántico”; lo confirma la cobertura de El País.
- Programación sobresaliente: muy buen rendimiento y coste/valor según comparativas externas.
- Coste efectivo más bajo: más densidad por token y precios agresivos en la presentación oficial de GPT-5.
- Punto débil: el enrutador puede subestimar la dificultad; conviene inducir verificación o forzar Thinking cuando el error cueste caro.
Tabla de contenidos
- Resumen ejecutivo
- Qué es GPT-5 y qué cambia
- ¿Decepcionante o pragmático?
- GPT-5 Thinking y enrutador
- Límites de uso y gestión
- Comparativa con O3 y O4
- Competidores y precio
- Programación: capacidades reales
- Experiencia de uso
- Consejos prácticos
- Pros y contras
- Conclusión y veredicto
Resumen ejecutivo del artículo (GPT-5 análisis / GPT5 análisis)
- Idea central: OpenAI reestructura su catálogo en torno a un único modelo “enrutado” que combina un modo instantáneo y uno razonador (GPT-5 Thinking).
- Expectativas vs realidad: no hay salto drástico frente a razonadores recientes; mejora incremental con foco en utilidad, coste y multimodalidad según la cobertura de El País.
- Puntos fuertes: programación (velocidad, calidad y coste), razonamiento sólido con Thinking/Pro, buena relación precio/rendimiento en análisis comparativos.
- Puntos débiles: decisiones erráticas del enrutador en consultas con “truco”; errores básicos si no se fuerza razonamiento; límites visibles.
- Para quién es: usuarios generales que quieren simplicidad y coste bajo; desarrolladores que valoran control del razonamiento.
Sigue leyendo: veremos qué cambia, cómo funciona el enrutado y en qué casos conviene forzar Thinking.
Qué es GPT-5 y qué cambia frente al catálogo anterior
Modelo unificado con enrutador
- Dos vertientes bajo el mismo selector: GPT-5 (respuesta instantánea) y GPT-5 Thinking (modo razonador con cómputo a demanda).
- El enrutador decide la vertiente según la “dificultad”. Tú eliges velocidad o permitir más “tiempo de pensamiento”.
Adiós al mosaico de modelos
- Desaparecen 4.1, 4.5, O3, 4o… Se simplifica a un flujo único con enrutado inteligente.
- La multimodalidad nativa: texto, imagen, audio y vídeo en un mismo hilo.
- OpenAI destaca eficiencia: respuestas con menos tokens y mayor densidad informativa.
Herramientas y modos
- Se mantienen: investigación/“modo agente”, canvas y ejecución de herramientas; la UX es unificada aunque bajo el capó haya especialización (nuevo entorno de trabajo).
Idea simple: un solo modelo, dos maneras de pensar. La clave es cuándo y cómo se activa el razonamiento.
Por qué se percibe como “decepcionante” y por qué aun así es un buen modelo
Expectativas altísimas
- La saga GPT-2→3→4 alimentó la idea de “saltos cuánticos”. El anuncio de GPT-5 llegó con promesas fuertes de escala y multimodalidad según El País.
Benchmarks vs realidad
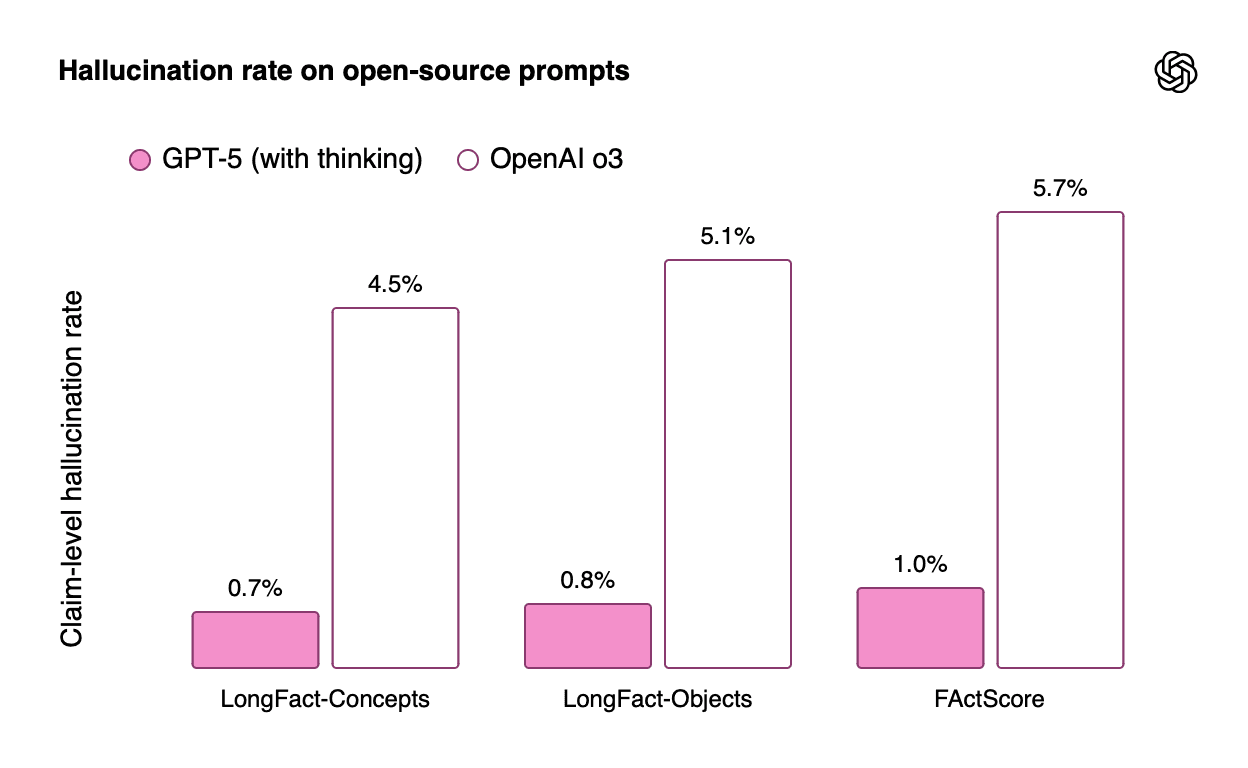
- Resultados cercanos a O3/O3 Pro; la mejora se siente en eficiencia y control.
- Algunos informes lo colocan líder en AIME y SWE-bench Verified (comparativa Creole Studios), pero en uso diario el avance es incremental.
Lectura estratégica
- OpenAI prioriza utilidad sostenible: velocidad, coste y UX unificada por encima de batir cada benchmark extremo.
Traducción al día a día: menos fricción eligiendo modelo, mejor programación a menor coste y razonamiento fiable cuando lo activas de forma explícita.
GPT-5 Thinking explicación (arquitectura, enrutador y dinámica de cómputo)
- GPT-5 Thinking: modo razonador con más “tiempo de pensamiento” y herramientas; incorpora técnicas para estructurar el pensamiento y verificar pasos (análisis de Raona).
- Eficiencia: necesita menos tokens de salida para decir lo mismo, con más densidad conceptual (Introducing GPT-5).
Enrutador (cómo decide)
- Evalúa la dificultad del prompt y elige instantáneo o razonador.
- Permite priorizar rapidez o permitir que “piense más”.
- Si subestima, te manda al modo instantáneo y aparecen fallos básicos.
Ejemplos reales
- 9,11 vs 9,9: instantáneo falla primero; al forzar Thinking, acierta a la primera.
- “¿Qué pesa más, 20 libras de ladrillos o 20 plumas?”: instantáneo cae en la trampa; Thinking razona “pesan lo mismo”.
Implicación y consejo
- El eslabón débil hoy es la decisión de enrutado; necesita refinamiento continuo.
- Prompt útil: “piensa tu respuesta en profundidad antes de responder; verifica y corrige”. Suele activar cómputo extra sin agotar siempre el cupo de Thinking.
Límites de uso y cómo gestionarlos
- Plus: 80 mensajes/3 horas en GPT-5; Thinking directo: 200 prompts/semana.
- Truco: usa la coletilla de verificación en GPT-5 normal para que el enrutador eleve compute cuando haga falta.
- Caída a modelos menores: si agotas cuota, descenso a GPT-5 Mini/Nano para tareas ligeras.
- Usuarios Pro: GPT-5 Pro añade más cómputo y paraleliza razonamiento (“high compute”), ideal para planificación/optimización/debug complejo.
Comparativa GPT-5 vs O3 y O4
- Continuidad técnica: evolución de O1/O3 con aprendizajes de O4; mejora estabilidad y gestión de herramientas.
- Benchmarks: Frontier Math mejora cuando se permite Thinking “alto”; en ARC-AGI 1 roza a los mejores; en ARC-AG2 “high compute” queda por detrás de Grok 4 ~6 p.p.
- Lectura rápida: mejora incremental, especialmente en programación y cadenas de razonamiento bajo presión.
- Contexto externo: líder en AIME 2025 y SWE-bench Verified con buen prompting y compute (fuente comparativa).
- Multimodalidad y contexto amplio: texto, imagen, audio y vídeo con ventanas muy grandes útiles para análisis largos (El País).
Conclusión parcial: no rompe con O3/O4, pero pule la experiencia y gana terreno cuando puede “pensar más”. Para muchos equipos, eso basta para migrar (visión de producto).
Comparativa con competidores y posicionamiento de precio
OpenAI sitúa GPT-5 en una franja agresiva de precio/valor para API: por debajo de 4.1 y mucho más bajo que 4.5, con caídas drásticas por unidad comparable (materiales de lanzamiento; comparativas públicas). Es una jugada directa contra Anthropic y Grok 4.
- Coste/eficiencia: menos tokens para decir lo mismo y menor latencia con calidad igual o mejor (Introducing GPT-5).
- Multimodalidad nativa: texto, imagen, audio y vídeo, clave para agentes (nuevo entorno; El País).
- Contexto amplio: ventanas cercanas al millón de tokens en algunas coberturas (El País).
- Rendimiento vs Anthropic/Grok: arriba en AIME 2025 y SWE-bench Verified en análisis externos; Grok 4 tiene wins puntuales en agencia compleja, brecha que se estrecha con “high compute”.
Para compras de empresa: menor TCO por más densidad por llamada, menos latencia y tiempos mejores sin sacrificar calidad.
Enfoque en programación: capacidades y evidencias prácticas
La programación es, quizá, su mejor terreno: velocidad + coste + razonamiento controlado permiten ciclos rápidos en IDEs y agentes.
- Proyecto “Snake en hexágono rotatorio”
- GPT-5 (17 s de pensamiento): primera versión no funcional; entiende el problema, falla en bordes.
- GPT-5 Thinking “high” (~2 min): revisa supuestos, corrige y llega a juego funcional en 1–2 iteraciones.
- GPT-5 Pro: implementación más estable, parámetros configurables, tests breves y hooks para RL.
- En el día a día de un dev: scaffolding limpio y modular, unit tests mínimos, refactor y docs con pocas indicaciones, integración de herramientas y APIs con precisión.
- En métricas de coding destaca en SWE-bench Verified, confirmando ejecución y corrección con tiempo de pensar (referencia de benchmark).
Experiencia de uso y detalles a tener en cuenta
- Canvas: a veces omite estilos o deja “ponlo tú aquí”. Fácil de arreglar, pero hay que revisar.
- Modo Investigación/Agente: capa visual unificada con especialización interna (documentación de producto).
- Señales positivas: problemas “trampa” que O3 Pro arrastraba durante minutos aparecen resueltos por GPT-5 cuando el enrutado activa Thinking a tiempo (comparativa externa).
Lo que vigilar
- Enrutador: si subestima, verás respuestas rápidas pero con errores. Solución: pedir verificación o forzar Thinking.
- Cuotas: planifica picos y ten fallback (Mini/Nano) para tareas simples.
Consejos prácticos de uso
Cuándo forzar Thinking
- Problemas con truco, matemáticas y lógica.
- Planificación multistep (calendarios, dependencias, rutas).
- Programación no trivial (estado, concurrencia, UI compleja).
Frases útiles para inducir cómputo extra
- “Piensa tu respuesta en profundidad antes de responder; verifica y corrige.”
- “Muestra los pasos y valida con un ejemplo mínimo.”
Control de límites
- Plus: usa la coletilla en GPT-5 normal para que el enrutador suba el cómputo sin gastar siempre el cupo de 200/semana.
- Reserva el selector Thinking para casos críticos.
- Si el sistema cae a Mini/Nano, cambia de tarea: outlines, extractos o pequeñas utilidades.
Mejores prácticas de prompting
- Pide estructura: “componentes, funciones y tests”.
- Solicita verificación: “comprueba casos borde y explica supuestos”.
- En datos extensos, fija objetivo y formato de salida.
Para desarrolladores y empresas
- Evalúa GPT-5 Pro si haces CI/CD, agentes en producción o pipelines paralelizables.
- Mide coste/rendimiento en tu propio repo frente a Anthropic o Grok 4: no te quedes solo con benchmarks (visión de OpenAI; comparativas).
Pros y contras
Pros
- Modelo unificado, simple de elegir e integrar.
- Gran valor en programación: rápido, fiable con Thinking y barato por tarea (presentación oficial).
- Multimodalidad real y ventana de contexto muy amplia (El País).
- Rendimiento top en AIME y SWE-bench Verified según terceros (Creole Studios).
Contras
- Enrutador aún inmaduro: puede mandar al modo rápido cuando no debe.
- Límites visibles si abusas de Thinking; hay que planificar uso.
- Pequeñas inconsistencias en herramientas (p. ej., canvas omitiendo partes).
Conclusión y veredicto
Menos marketing, más trabajo bien hecho. GPT-5 no es un “salto de era” mágico: es una mejora seria enfocada en utilidad, coste y flujo de trabajo. La clave operativa: deja que piense cuando importe y controla tus cuotas. El talón de Aquiles es el enrutador; si se afina, la experiencia subirá para el usuario medio. Aun así, el balance es positivo: buen razonamiento, gran velocidad, multimodalidad íntegra y precio agresivo (Introducing GPT-5; New era of work; El País).
Recomendaciones por perfil
- Usuarios generales: adopción sin fricción; usa la coletilla de verificación en tareas serias.
- Desarrolladores: prueba GPT-5 Thinking/Pro en proyectos reales; mide coste/beneficio en tu repo y CI.
- Empresas: explota precio/velocidad para agentes y programación; controla el enrutado en flujos críticos.
FAQ: preguntas rápidas
¿GPT-5 es un razonador?
Depende del enrutador. Tienes el modo instantáneo y GPT-5 Thinking, que añade pasos y verificación para resolver problemas difíciles (análisis técnico; documentación de OpenAI).
¿En qué supera a O3 y O4?
En eficiencia, estabilidad y coste/rendimiento; en programación suele rendir mejor, y aparece arriba en AIME y SWE-bench Verified según terceros.
¿Cuáles son los precios?
Se posiciona por debajo de 4.1 y mucho más bajo que 4.5, con recortes fuertes por unidad comparable. Además, necesita menos tokens para responder, bajando el coste efectivo (fuente oficial; comparativas).
¿Cuáles son los límites?
Plus: 80 mensajes/3 horas en GPT-5. Thinking directo: 200 prompts/semana. Con la coletilla de “piensa en profundidad…”, el enrutador puede elevar compute sin gastar siempre ese cupo. Si agotas, cae a Mini/Nano.
¿Cuándo usar Pro?
En tareas complejas o paralelizables: planificación, optimización, refactors grandes, agentes que coordinan varias herramientas. El extra de cómputo compensa por calidad y menor retrabajo (guía de casos).
¿Qué hay de la multimodalidad y el contexto?
Puedes mezclar texto, imagen, audio y vídeo en el mismo flujo, con una ventana de contexto muy amplia, útil para análisis extensos, compliance y educación (El País; OpenAI).
¿Consejo rápido para mejores respuestas?
Pide pasos, verificación y tests. Ejemplo: “piensa en profundidad antes de responder; valida con un ejemplo mínimo y explica supuestos.” Funciona bien para lógica y código (recomendación técnica).
¿Dónde encaja en la comparativa GPT-5 vs O3 y O4?
Es una evolución práctica: mejora incremental con más eficiencia y mejor experiencia cuando se activa el razonamiento. Para muchos, la migración compensa por coste y UX (comparativa; visión oficial).
Cierra este GPT5 análisis probando en tu propio flujo: mide tiempos, tokens y calidad. Ahí está la verdad que importa.